你调了三周的那条 prompt 不是资产,是负债
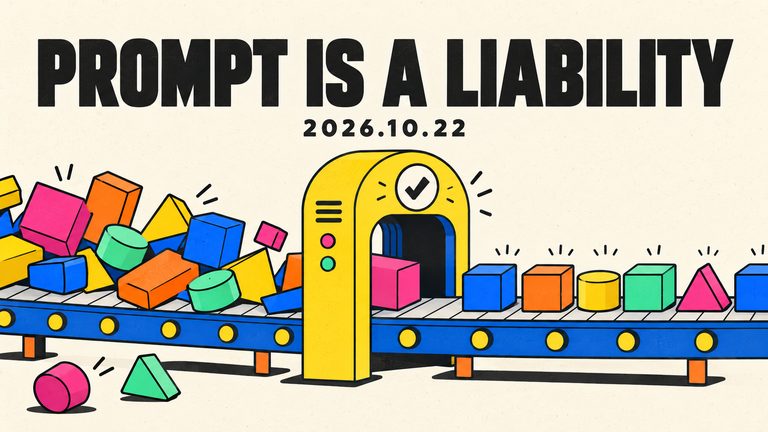
凌晨三点,CI 里那条 prompt 又跑完了。
输出是一个 JSON 文件,看着没毛病:字段齐、格式对、体积正常。下游脚本接着往下走。等到早上有人打开看板,才发现「活跃用户」那一列是空的。模型把字段名写成了 active_users,而下游读的是 actives。
文件存在,退出码 0,日志里没有一个红字。这类故障比崩溃难查得多。崩溃至少会喊一声。
Charlie Guo 和 Gabriel Chua 在 AI Engineer World’s Fair 2026 的 workshop 上讲了这个场景。Guo 是 OpenAI 的 DevX 工程师,开场那句话挺呛:the magic phrase is dead, long live the software factory. 魔法咒语死了,软件工厂万岁。
呛归呛,这话说的不是「别练措辞了」。它说的是:如果你把 prompt 当成复用的单位,你就是在依赖一个不能审计、不能排期、不能交给 subagent 的东西。
一次性用没问题,变成流程才开始漏#
一次性 prompt 就是跑一遍、看输出、决定发还是扔。当探索工具用,完全合适。
坑出现在它被当成流程之后:你或者同事,拿它反复跑,换不同的输入,指望结果稳定。
Guo 拆了三个窟窿。
第一个最阴:早期成功把脆弱藏起来了。 在你自己挑的那个测试用例上,输出漂亮得让人想截图。于是没人有动力去摸它的边界。第一次失败往往不在生成环节,而是在下游,在生产里、在 code review 里、在测试套件里炸出来。
第二个:没有完成判据。 prompt 会产出东西,但那个东西对不对,全靠看的人。看的时候仔细、风险又低,这不算问题。赶时间的时候、输出很长的时候、看的人其实不清楚「对」是什么样的时候,它就变成问题。prompt 没法告诉你它正确地完成了,它只能停止吐 token。
第三个:没法当流程资产。 prompt 不是规格书。你没法把它递给新同事,让对方明白这个流程该产出什么、有什么约束、要过哪几道验证、人要在哪一步签字。prompt 是给模型的一条指令,流程要的东西比这多。
一条条看都不算致命。叠在一起就是:你的工作流依赖一个你没法审、没法排期、没法外包给 agent 的物件。
一次性 prompt 和工厂里的一步,差在哪儿#
工厂模型不取代 prompt,它给 prompt 安排位置。在流水线里,prompt 只是一步,这一步有明确输入、单一职责、可验证的输出,以及交给下一步或交给人的交接点。
差别不是措辞好不好,是这一步能干什么:
| 能力 | 一次性 prompt | 流水线里的一步 |
|---|---|---|
| 出错时定位 | 整个 run 是一个黑盒 | 哪一步错,当场停在那一步,上下文完整 |
| 交给 subagent | 只能连人一起交 | 给 brief 和判据就行,协调者不必懂实现 |
| 排期运行 | 不敢,没人看着不放心 | 半夜、云端、无人值守都能跑 |
| 事后审计 | 只有一份最终产物 | 每步的输入、输出、验证命令、是否通过都在 |
第三行最容易被跳过。一条嵌进 crontab 或 CI job 的 prompt,是被运营化了,但没被工厂化。它没有完成判据,没有内部检查点,没有约定的人工介入间隔。它是伪装成流水线的一次性 prompt。
先分类,别急着全改#
不是所有用法都值得建流水线。该问的是:我手上这些用法里,哪些正背着它不该背的风险。
该保持一次性的:
- 探索性生成,起草、头脑风暴、第一版汇总,你本来就打算通读一遍然后大删
- 只跑一次、而且输出在任何人动手之前会被 100% 看完的任务
- 输入永不重复的任务,一次性的数据迁移、给某个客户定制的配置文件
已经在裸奔的:
- 你或同事跑过两次以上、还指望结果一致的 prompt
- 输出直接进生产(代码、配置、文档、数据),却没有明确 review 判据的 prompt。「我看一眼就知道对不对」不算判据
- 属于更长工作流的一环,输出是下一步的输入的 prompt
- 已经被写进 runbook、脚本或 CI job 的 prompt
第四条最危险。写进脚本那一刻,它就脱离了「有人在旁边看着」的保护,却没有换来任何机器可验证的东西。
五步,把一步建起来#
Guo 和 Chua 给的框架有五件事。落到 Codex CLI 上大概是这样。
一,把输入格式说死。 不是「一些代码」,是「src/ 下没有 JSDoc 注释的 TypeScript 文件」。不是「当前任务」,是「带复现步骤和期望行为的 GitHub issue 正文」。说死有两层好处:把模型往范围内挤,以及让这一步可测,你能先造几个合成输入去打边界,再让它碰真数据。在 AGENTS.md 里,这对应任务块开头的 context: 段,写清楚这一步期望收到什么,不只是该产出什么。
二,拆到单一职责。 一步干两件事,就有两个输出要验、两个独立的失败模式。「写完这个函数并且补上测试」应该拆成两步。Guo 的判断法很好用:如果你描述任务时用了不止一个 and,这就是该拆的信号。
三,写机器能判的完成条件。 不是「代码看起来对」,是 go test ./... 退出 0。不是「文档写了」,是 src/api/ 下每个导出函数都有 JSDoc 块。Codex 的 PostToolUse hook 让这件事能落在步骤边界上:模型写完,hook 跑验证命令,把结果交回协调者,不通过就这一步失败,流水线不往下走。
[[hooks.post_tool_use]]
name = "verify-step-3"
run  = "./scripts/verify-step-3.sh"
四,标出验证范围。 不是每一步都要人签字。写进 tests/ 的可以机器验完直接过;写进 src/core/auth/ 的,下一步之前该停一下。用 AGENTS.md 的 require-approval 块逐步表达,而不是全局设成「什么都问我」。前者是决策,后者是偷懒。
五,定监督间隔。 长跑或定时流水线,要写清楚人多久看一次状态。不是看每个输出,是确认流水线在按预期走。v0.164.0 alpha 的 observation hook 会把检查点事件抛出来,人不用一直守着。「每四步扫一眼事件流」比「跑完再看」好,比「出问题再说」好太多。
想动手的话别一次改全部。找一条你或团队每周跑两次以上的 prompt,先改这一条:写下输入格式,拆开多职责的部分,写一条能用 shell 命令表达的完成判据,决定哪几步需要人签字。把这些塞进 AGENTS.md,带人工盯一次跑通。跑通了,你就有了一个能交给 subagent、能排期、能事后审计的步骤。
我的看法:这套东西贵在哪儿#
判据写起来通常比 prompt 慢。写 prompt 是表达意图,写判据是定义正确,后者难得多,而且很多人对自己代码库的「正确」其实说不清楚。第一次做会很难受,因为你被迫承认有些东西从来没被定义过。
还有一类任务根本不适用。文案、视觉、架构取舍,这些的「对」没法写成 exit 0。硬套的结果是一堆形式主义判据,跑起来全绿,实际什么都没保证。
另外一个反直觉的地方:判据越硬,模型越容易冲着判据走捷径。让它「每个导出函数都有 JSDoc」,它会给你一堆 /** TODO */。所以判据最好放在模型改不到的地方,比如 hook 里、CI 里,而不是写在 prompt 里让它自己检查自己。这也是为什么 PostToolUse 比在 AGENTS.md 里加一句「记得跑测试」靠谱。
最后一点是我自己踩出来的:先给停机信号,再给完成信号。半夜跑挂的流水线,最怕的不是结果不对,是没人知道结果不对。哪怕判据还没写好,先让失败有个响动,也比安静地错下去强。
魔法咒语没有死。真正把它从依赖变成资产的,是外面那圈流水线。
参考来源#
Charlie Guo & Gabriel Chua, “Cooking with Codex”, AI Engineer World’s Fair 2026, 2026-10-06. youtube.com/watch?v=FwiS44-xyYw
延伸阅读:The Software Factory Mental Model: When One-Shot Prompts Become a Liability